一句话概括:本文只讨论方法本身——如何把不同传感器的观测写成残差,如何推导每个残差对状态的雅可比,如何构造鲁棒损失,如何组装稀疏正规方程并求解。全文不绑定具体平台、具体数据或具体实验结果。
多传感器融合的难点通常不在“把数据放进滤波器”,而在四个连续的问题:状态怎么参数化、观测怎么构造、雅可比怎么推、损失和优化怎么做。这四步任何一步含糊,系统都会表现成“能跑但不可解释”:残差量纲不一致、雅可比符号错、鲁棒核把真实运动当成外点、稀疏结构被破坏,最后只能靠调参掩盖。
本文把一套相对定位的建模方法拆开来讲。传感器只作为观测类型的例子:位姿观测(如视觉 PnP)、距离观测(如测距传感器)、相对运动观测(如体里程计)、平滑先验和一元先验。具体平台、具体安装方式和具体参数都不在讨论范围内。
一、问题抽象与状态参数化
设世界系为 ,目标机体系为 ,传感器系为 。相对定位要估计的是目标在 中的位姿。对地面移动目标,roll/pitch 近似为零,状态可以退化为 4 自由度:
其中 是位置, 是偏航角, 是滑窗长度。整窗状态维度是 。
状态更新写作流形上的扰动:
这里的 表示状态在流形上的扰动更新,不是普通加法。yaw 必须做 ,否则角度环绕会让残差在 附近跳变。位置和 yaw 的扰动维度分别是 3 和 1,因此每个状态块的雅可比列数是 4。若使用完整 6-DoF 位姿,应把扰动定义在 的右扰动上;本文的 4-DoF 是其平面特例。
观测写成一般形式:
残差的正负号约定必须全局一致:本文统一用“测量减预测”。如果某一段实现用“预测减测量”,它的雅可比要整体取负,否则在联合优化里会互相抵消。这个错误在单传感器测试里不容易发现,但在多传感器联合时表现为“越优化越差”。
二、观测构造的统一范式
任何观测都可以按三步构造:
- 写观测函数:把测量写成状态的函数 ,而不是直接拿测量值当状态。
- 做时间与坐标对齐:把状态预测到测量时刻,把测量变换到同一世界系;这一步会引入运动模型和外参。
- 定义残差与权重:,把不同量纲的观测归一化到同一尺度。
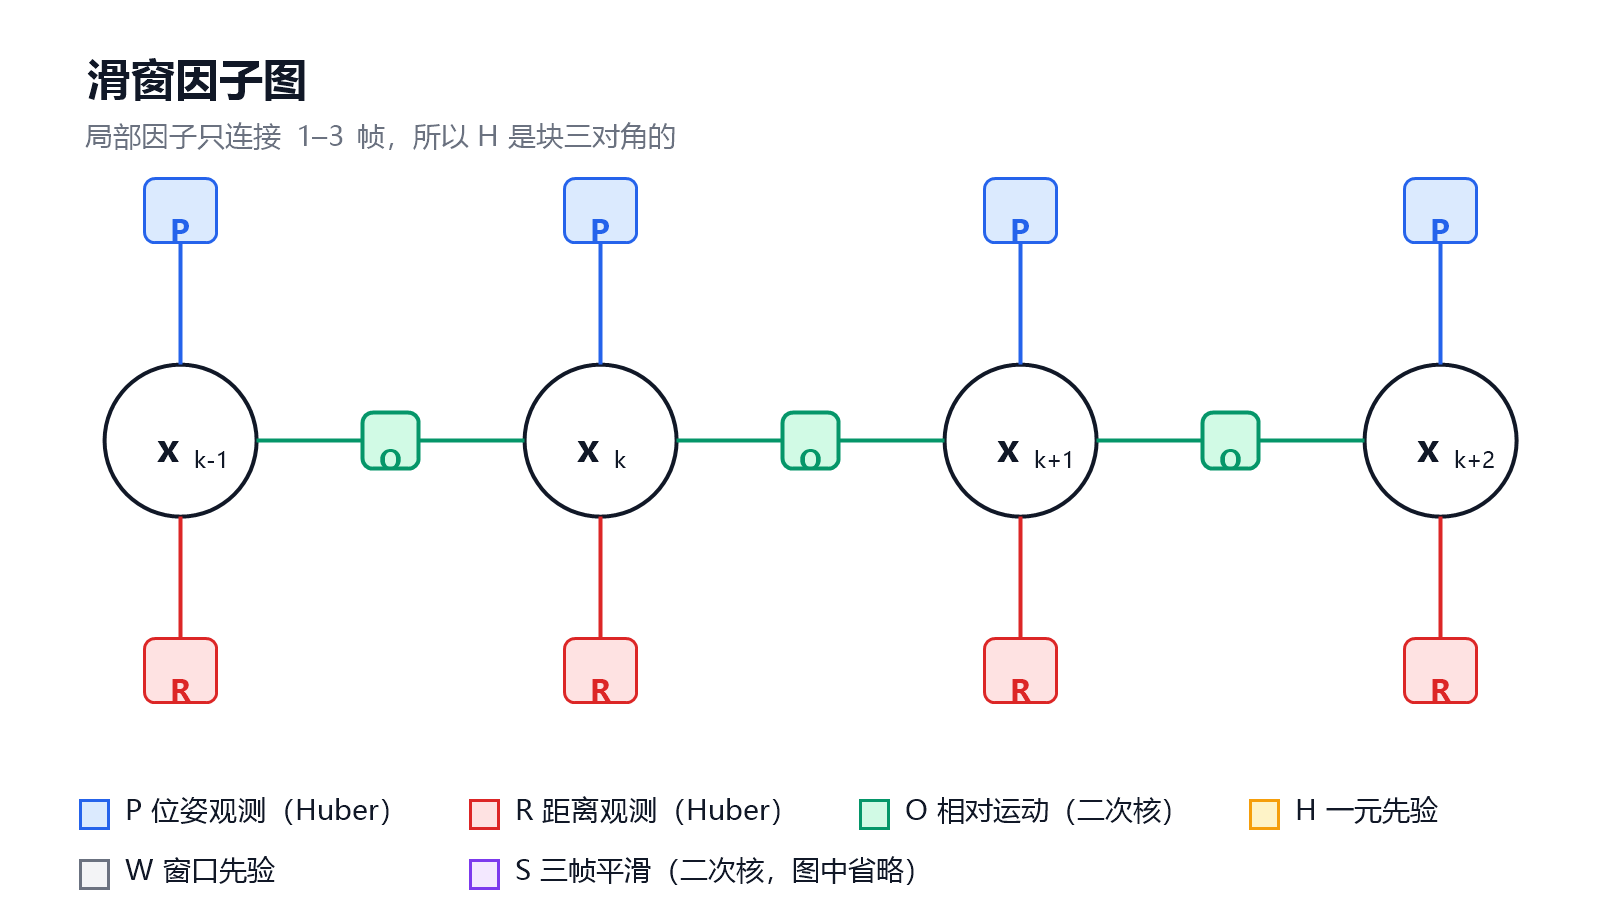
常见的观测类型可以归纳为下表。维度是残差维度,支撑集是残差关联的状态块:
| 观测类型 | 观测函数 | 残差维度 | 支撑集 |
|---|---|---|---|
| 绝对位姿 | 位置 + yaw | 4 | 单帧 |
| 距离 | 两点间欧氏距离 | 1 | 单帧 |
| 相对运动 | 相邻帧位移 + yaw 增量 | 4 | 相邻两帧 |
| 平滑先验 | 位置二阶差分 | 3 | 连续三帧 |
| 一元先验 | 高度/窗口锚点 | 1 或 4 | 单帧 |
三、观测残差的具体形式
1. 绝对位姿观测
设测量为 和 。由第 帧状态经运动模型外推到测量时刻 :
残差为:
位置权重不是常数,而是按观测几何质量放大:
其中 是观测基准数量, 是实际可见数量, 是观测深度; 是基准权重, 是参考深度,、 是经验指数。这是一个单调的“可信度代理”:可见特征越少、距离越远,位姿误差越大。若观测存在二义性(例如平面单标记),再乘一个惩罚因子 。它不是严格的协方差传播,而是把几何质量编码进权重。
2. 距离观测
其中 是另一端/观测源的位置, 是距离偏置, 是尺度, 是鲁棒权重。单距离观测只有一行,它约束的是一个球面,而不是一个点:径向可观测,切向不可观测。
3. 相对运动观测
位移 由体速度按中点 yaw 积分得到; 和 控制这条边有多“硬”。这是一个设计取舍:权重太小,标定误差会直接拉偏轨迹;权重太大,盲区里又没有足够的运动约束。
4. 平滑先验与一元先验
其中 、、 分别是平滑、高度和窗口先验的尺度。平滑先验不是物理加速度,而是“轨迹不要逐帧抖动”的弱约束;一元先验给高度或窗口锚点一个弱绝对参考,防止整个窗口在零空间里漂走。
四、雅可比构造
这是全文最核心的部分。雅可比不是“对残差求导”这么简单:必须明确对哪个扰动求导、在哪个点求导、残差的正负号是什么。本文统一在 处对 求导。
1. 基础块:旋转对 yaw 的导数
记 ,,。有:
这个 3×1 向量会反复出现在位姿、距离和相对运动的雅可比里。先把它写好,后面的推导只是链式法则。
2. 绝对位姿观测的雅可比
残差对 求导。位置部分对 是单位阵,对 是上面的旋转导数;yaw 残差对位置没有依赖,对 yaw 是 1:
如果预测使用了另一个锚点状态 (例如由锚点外推),则还要对锚点加一块:
这一步是很多实现出错的地方:残差里明明用了里程计外推,却只对当前帧求导,导致优化器看不到锚点误差。
3. 距离观测的雅可比
令 为由目标指向观测源的单位向量。距离对 的导数是 ,再经链式法则得到:
只有一行,所以它只约束径向。若观测源位置本身也有误差,需要对观测源状态再加链式项;若距离模型包含偏置/尺度,偏置和尺度也要作为状态或标定量处理。
4. 相对运动观测的雅可比
残差依赖四个块:。逐块求导:
如果相对位移带尺度 ,且 也作为状态,则再加一列:(位置行)和 (yaw 行)。如果位移由时间积分得到,时间偏移也要通过链式法则进入。
5. 平滑与一元先验的雅可比
平滑残差对三帧的雅可比是 3×12:
高度先验的雅可比是 1×4:
窗口先验的雅可比是 4×4 的单位阵除以 ,只落在最老帧。
6. 雅可比组装与稀疏结构
把每个残差块的雅可比按列“散射”到全局矩阵。设状态块 的列偏移是 ,则对每个残差块:先确定它在全局残差中的行区间;再对该块支撑的每个状态 ,把局部雅可比写入列区间 ;最后用 COO/CSR 累加。
因为每个因子只关联 1–3 个状态, 是稀疏的, 是块三对角的。不要先构造稠密矩阵再“转稀疏”;直接在组装时用 COO/CSR 累积,可以避免大量零元。
雅可比写完后,必须做数值检查。对随机扰动 ,验证:
如果误差随 线性下降,说明雅可比方向对;如果误差不降或随 变大,通常是符号、链式项或 yaw wrap 写错了。这个检查比“看优化结果像不像”可靠得多。
五、损失构造与鲁棒核
观测残差定义之后,下一步是决定“如何惩罚残差”。这一步看似只是选一个核函数,实际上决定了估计器的统计假设、抗粗差能力和收敛行为。损失构造得不对,雅可比再准也会被几个外点带偏;损失构造得过度,真实的快速运动又会被当成外点压掉。
1. 从最小二乘到 M 估计
如果残差服从零均值高斯分布,负对数似然给出二次损失:
二次损失对大残差惩罚过快:一个粗差可以主导整个代价,把解拉到一个“折中”的位置。M 估计把二次损失替换成一般鲁棒函数 :
是影响函数, 是等效权重。二次损失的 、;Huber 在 内保持二次,之外让影响函数饱和;Cauchy/Tukey 则是“redescending”——影响函数在远处会回落,甚至把极端外点的权重降到零。
| 损失 | 影响函数 | 等效权重 | 特点 |
|---|---|---|---|
| 二次 | 凸函数、无抗粗差能力 | ||
| Huber | (近端);(远端) | (近端);(远端) | 凸函数、影响函数有界、适合初始化 |
| Cauchy | 非凸、远端权重衰减 | ||
| Tukey | 完全拒绝极端外点、需要好初值 |
选择哪一种,取决于“外点比例”和“初值质量”。Huber 是凸的,优化行为最可预测,适合作为默认选择;Cauchy/Tukey 更激进,但非凸,初值不好时容易陷入局部极小。如果必须使用 redescending 核,通常要配合渐进非凸(GNC)或先用 Huber 热启动。
2. Huber 核的构造细节
Huber 核的定义是:
它在 处一阶连续:左侧导数是 ,右侧导数也是 。这个 C1 连续性对 LM 很重要:如果损失函数在阈值处导数跳变,高斯-牛顿的二次近似会在阈值附近来回震荡。
是“归一化残差”尺度上的阈值。因为残差已经除以 ,它相当于“多少个标准差”以内仍按二次处理。阈值太小,真实噪声也会被当成外点,估计效率下降;阈值太大,粗差又会重新获得二次影响力。它没有通用最优值,需要结合外点比例、初始化质量和传感器可信度选择。
还有一个容易忽略的细节:Huber 是逐标量作用,还是按残差向量的范数作用?
- 逐标量:每个分量独立计算 。实现简单,能单独压制某个方向上的粗差;但它不是旋转不变的,分量坐标改变会改变权重。
- 按范数:先用 算一个标量权重,再对整个向量块统一缩放。它是旋转不变的,但一个分量坏了会连累整个块。
工程上通常对位姿残差采用逐分量 Huber(位置和 yaw 的量纲已经分别归一化),对距离残差采用标量 Huber。关键是保持一致性:不要把两种策略混在同一个残差块里。
3. 残差归一化与协方差白化
鲁棒核的阈值只有在“残差已经归一化”时才有意义。最简单的归一化是给每类观测一个标量 :
如果观测是多维的,并且已知协方差 ,应该做 Mahalanobis 白化:
这样残差的每个方向都变成单位方差,鲁棒核的阈值才在各方向上一致。如果直接对原始残差套 Huber,而不同方向的量纲不同(例如位置用米、yaw 用弧度),阈值就会在某些方向上过松、在某些方向上过紧。
没有完整协方差时,标量 是一种对角近似。它不能表达方向相关性,但至少把量纲统一了。使用标量近似时,要在文档里写清楚:这是工程权重,不是严格的后验协方差。否则下游会把 误读成真实不确定度。
4. 鲁棒核的分组策略
鲁棒核不应该“全图统一”。按物理语义分组,通常更稳:
| 观测组 | 典型失效 | 处理 |
|---|---|---|
| 外感受位姿 | 遮挡、误匹配、二义性 | Huber + 重投影/几何门控 |
| 距离 | NLOS、多径、偏置漂移 | Huber + 跨传感器门控 |
| 相对运动 | 尺度误差、打滑、积分漂移 | 二次核;必要时建模尺度 |
| 平滑/先验 | 模型误差、真实机动 | 二次核;调尺度而不是加鲁棒核 |
为什么不给相对运动也加 Huber?因为相对运动描述的是物理连续性,不是“可能说谎的观测”。如果给它加鲁棒核,优化器可以用“这是外点”来解释真实的快速运动,轨迹会变平滑但不再可信。鲁棒性要加在“可能说谎”的观测上,而不是所有地方。
门控和鲁棒核也不是二选一。门控适合“完全错误”的观测(例如关联错、NLOS 极大偏差),直接删除;鲁棒核适合“误差较大但仍然有信息”的观测,降权而不是删除。工程上常见组合是:先用几何/跨传感器门控剔除离谱观测,再用 Huber 处理剩下的中等粗差。
5. IRLS 的推导与实现
有了 ,目标是最小化 。对 求导并令其为零:
定义 ,上式变成加权最小二乘的驻点条件:
在当前点固定权重,对 做高斯-牛顿线性化,就得到:
IRLS 的流程是:
- 用当前 计算残差 和权重 ;
- 固定权重,解加权最小二乘,得到增量 ;
- 更新 ;
- 重复,直到权重或代价不再明显变化。
从优化角度看,IRLS 可以理解为一种 majorize-minimize:在当前点用一个二次函数去“包住”鲁棒损失,最小化这个二次上界,再在新点重新构造上界。Huber 的凸性保证了这个过程通常稳定;Cauchy/Tukey 的非凸性则可能需要 GNC 或更小的步长。
实现上通常不显式构造 ,而是把残差和雅可比逐行乘 :,。这样 ,直接做稀疏矩阵乘法即可。这个技巧不仅省内存,也避免了对角矩阵乘法的额外开销。
IRLS 和 LM 的嵌套方式有两种:
- 外层 IRLS、内层 LM:固定权重,跑若干次 LM;权重稳定后再进入下一轮。实现清晰,但总迭代次数可能较多。
- 每次 LM 迭代都重算权重:把权重看成随当前残差变化的量,收敛更快,但权重和步长会耦合,调试更困难。
无论哪种方式,都要监控“真实鲁棒代价”是否下降,而不是只看加权二次代价。加权二次代价在权重更新后会变,单看它可能误判收敛。
6. 损失构造的检查清单
- 残差是否已经按 或协方差白化?没有归一化就不要谈 ;
- 鲁棒核是否只加在“可能说谎”的观测上?运动学约束是否仍然是二次核?
- Huber 是逐分量还是按范数?同一残差块内部是否一致?
- 是否与归一化尺度匹配?阈值附近的影响函数是否连续?
- 是否同时使用了门控和鲁棒核?门控剔除“完全错”的观测,鲁棒核处理“误差较大”的观测;
- 是否在合成外点上验证过:加一个粗差,权重是否下降、代价是否没有被单个残差主导?
- 是否检查了真实机动下的行为:快速运动是否被误判为外点?
六、优化求解
损失构造把问题变成加权非线性最小二乘;优化求解负责在流形上找到使代价下降的增量。这里的关键不是“调一个求解器”,而是理解高斯-牛顿、LM、稀疏线性代数和流形更新之间的关系。
1. 高斯-牛顿与正规方程
对残差做一阶线性化:
加权二次代价变成:
令 ,,对 求导并令其为零,得到正规方程:
是半正定的;如果问题存在规范自由度(整体平移、整体旋转), 会有零特征值,正规方程奇异。解决方式不是“随便加一个小数”,而是显式加先验、固定首帧,或者用 LM 的阻尼项。高斯-牛顿在初值靠近最优解时有二次收敛,但在强非线性或初值不好时可能发散,所以需要阻尼。
2. LM 阻尼与信赖域
LM 在正规方程上加一个阻尼项:
控制“信任高斯-牛顿近似”的程度: 很小,接近高斯-牛顿; 很大,步长变小、方向接近梯度下降。用 而不是单位阵,是为了让阻尼与各状态的尺度匹配;否则量纲大的状态会被过度阻尼。
求出 后,计算真实代价的下降与二次模型预测的下降之比:
分母是二次模型预测的下降量。若 ,接受该步; 接近 1,说明二次近似很好; 很小或为负,说明近似很差,应该增大 并重试。常见策略是:接受后把 缩小若干倍,拒绝后放大若干倍;具体倍数不是理论重点,关键是“只在真实代价下降时接受”。
收敛判据通常组合使用:梯度范数、步长范数、代价相对变化、 上限、最大迭代次数。只看步长小是不够的:可能是在一个平坦区域里停住;只看代价变化也不够:可能代价很大但相对变化很小。
流形更新要在最后做:
如果步长过大,即使代价下降,也可能跨过正确的盆地。可以在更新前做步长限幅,或者把 LM 的初始 设大一些,让前几步更像梯度下降。
3. 稀疏线性代数
由因子图的局部连接, 是块三对角的。直接把它当稠密矩阵分解,复杂度会随窗口长度立方增长;利用稀疏结构,复杂度主要取决于非零元和填充。工程上有三种常见做法:
| 方法 | 适用结构 | 特点 |
|---|---|---|
| 稀疏直接法 | 块三对角、小窗口 | 稳定、实现简单;需要好的消元顺序控制填充 |
| Schur complement | 边缘化旧状态 | 把大问题拆成“旧状态消元 + 新状态求解”;会引入填充 |
| 增量式 / iSAM2 | 长期滑窗、因子增量更新 | 只更新受影响的部分;实现复杂,需要维护贝叶斯树 |
| 迭代法(PCG) | 超大窗口、H 稀疏 | 内存友好;需要预条件子,收敛依赖条件数 |
直接法里,消元顺序很重要。AMD/COLAMD 之类的排序可以减少填充;如果不能重排,就要接受填充带来的额外非零元。对块三对角结构,按时间顺序消元通常已经接近最优;如果同时有全局先验或回环,填充会变多,需要重新排序。
Schur complement 的形式是:
先解 ,再回代 。边缘化不是“把旧状态删掉”这么简单:被边缘化的信息会变成先验,进入 和后续的 。如果先验没有维护好,系统会丢失历史约束,或者因为填充导致稀疏结构退化。
4. 初值、热启动与鲁棒初始化
非线性优化对初值敏感。常用的初始化顺序是:
- 有绝对位姿观测的帧:直接用观测初始化位置和 yaw;
- 没有绝对观测但已有前一帧:用相对运动递推;
- 长盲区:以最后一个绝对锚点为起点,沿相对运动递推,并用带限幅的弱观测做软牵引;
- 多解情况:保留多个候选,用残差/一致性评分选一个,或者同时保留到优化里做多假设。
滑窗滚动时,热启动可以显著减少迭代:把上一窗的状态平移到新窗,保留重叠部分,新帧用相对运动外推。热启动不是“偷懒”,而是利用时间连续性;但要注意:如果上一窗解已经错了,热启动会把错误带进来。此时需要更大的初始 、更保守的步长,或者从绝对观测重新初始化。
鲁棒初始化还包括“损失调度”:先用凸的 Huber(甚至二次损失)把解拉到大致正确的位置,再切换到更激进的核;或者用 GNC,让核的阈值从大到小逐渐收紧。直接上 Tukey 这种 redescending 核,初值不好时很容易把所有观测都当成外点。
5. IRLS 与 LM 的嵌套
把损失和优化放在一起,完整的迭代可以分成外层和内层:
- 初始化状态 ,设定初始阻尼 ;
- 外层:用当前 计算残差 和鲁棒权重 ;
- 内层:固定权重,组装 、,解 LM 步 ;用真实鲁棒代价判断接受或拒绝,并更新 ;
- 重复内层,直到收敛或达到迭代上限;
- 如果权重或代价不再明显变化,结束;否则回到外层。
外层负责更新鲁棒权重,内层负责在固定权重下求解加权最小二乘。内层不必每次跑到完全收敛:外层权重变化后,内层的解本来就会变;跑几次 LM 通常足够。关键是每次接受步都要用真实鲁棒代价判断,而不是用加权二次代价。
如果每次 LM 迭代都重算权重,实现可以更短,但调试更难:权重和步长耦合,出现震荡时不容易判断是核函数、雅可比还是阻尼的问题。建议先采用“外层 IRLS、内层 LM”的清晰结构,再做性能优化。
6. 实时预算与失败处理
在线系统不能假设优化一定收敛。需要显式的失败处理:
- 迭代上限:限制外层/内层迭代次数,避免极端帧拖死主循环;
- 时间护栏:在迭代边界检查预算,超时就返回当前最好解;
- 回退策略:如果连续拒绝步或线性求解失败,回退到上一帧解/相对运动外推,并标记该帧质量;
- 诊断输出:记录代价、梯度范数、步长、、有效观测数、门控数量,便于离线定位;
- anytime 语义:允许“现在返回一个稍差但可用的解”,而不是“要么最优、要么没有输出”。
这些机制不是实现细节,而是方法的一部分:它们决定了系统在观测退化、数值病态和计算拥塞时是否还能保持可控。
7. 求解流程
一次滑窗求解的流程可以概括为:初始化 → 构造残差与雅可比 → 计算鲁棒权重 → 组装稀疏正规方程 → LM 阻尼求解 → 流形更新 → 收敛/预算判断。观测构造给出 和 ,损失构造给出 ,稀疏线性代数给出 ,流形更新给出 ,实时预算决定什么时候停。
七、可观性、规范自由度与条件数
优化能解出数,不代表问题可观测。至少要区分三件事:
- 规范自由度:世界系的全局平移和 yaw 不可由相对观测唯一确定,需要一元先验或固定首帧;
- 弱可观方向:单距离只约束径向;单标记位姿存在平面二义性;盲区里切向位置主要靠运动先验;
- 数值条件:即使理论上可观测,权重差异过大也会让 的条件数变差,LM 步长不稳定。
| 观测组合 | 可观测 | 弱/不可观测 |
|---|---|---|
| 多特征绝对位姿 | 位置、yaw、尺度 | 深度随距离变弱;外参不可自检 |
| 单特征绝对位姿 | yaw、部分位置 | 平面二义性;深度弱 |
| 单距离 | 径向距离 | 切向位置;单球面无法定位一个点 |
| 仅相对运动 | 相对位移 | 全局位置/航向漂移 |
诊断方法很直接:对 做特征值分解,检查最小特征值是否接近零;如果接近零,检查对应的零空间方向是不是“整体平移/整体旋转”。也可以固定一个状态块,看 的条件数是否显著改善。条件数过大时,优先检查权重量纲和状态缩放,而不是盲目加阻尼。
八、验证方法
不依赖具体数据,也可以系统地验证建模是否正确:
- 雅可比数值检查:对每个残差块,用随机扰动比较解析 与数值差分 ;
- 合成数据验证:用已知真值生成观测,检查优化是否收敛到真值附近,以及残差是否符合噪声模型;
- 残差一致性:在正确建模下,归一化残差应接近零均值、单位尺度;如果某个传感器的残差有偏或重尾,说明观测函数、外参或权重有问题;
- 消融设计:逐项移除观测/先验,观察零空间、条件数和轨迹变化,而不是只看最终误差;
- 蒙特卡洛:对噪声和初值多次采样,统计收敛率、失败模式和协方差一致性。
这些验证不依赖具体平台,也不依赖某次实验的数据;它们检验的是“建模和实现是否自洽”。
九、方法清单
把上面的内容压缩成一张可执行的清单:
- 定义状态与扰动:位置、yaw、外参、尺度、时间偏移;明确哪些是状态、哪些是标定量;
- 定义观测函数:每个传感器写成 ,不要直接拿测量值当状态;
- 做时间与坐标对齐:运动模型外推、外参变换、时间戳对齐;
- 写残差并归一化:统一符号,按 或协方差白化;
- 推雅可比:先写基础旋转导数,再按链式法则逐块组装;
- 做数值检查:每个残差块都跑有限差分对比;
- 选损失:外感受观测用 Huber,运动学与先验用二次核;多维观测先白化;
- 组装稀疏系统:COO/CSR 累积,保持块三对角;
- 求解与更新:LM 阻尼、真实代价接受、流形更新、热启动、预算熔断;
- 检查可观性:零空间、条件数、先验是否固定规范自由度;
- 分离输出层:估计器对观测负责,输出层对控制器负责。
十、局限与扩展
这套方法有明确的适用边界:
- 标量权重:每类观测一个 是对角近似,不能表达方向相关的不确定性;
- 4-DoF 平面假设:只适用于地面移动目标;空中/水下/爬坡目标需要 6-DoF 和 扰动;
- 单距离观测:切向不可观,只能做径向约束和门控;
- 离线标定:外参、尺度、时间偏移没有在线估计;
- 平滑先验不是物理模型:没有 IMU 预积分,快速机动会被过度平滑;
- 输出层有群延迟:因果滤波必然带来滞后,控制器需要留相位裕度。
扩展方向也很直接:把外参、尺度、时间偏移纳入状态做在线估计;用 IMU 预积分替代二阶差分;用多锚点测距/测角让切向可观;用学习的方法做坏观测检测但保留几何优化的可解释性;窗口更大时用 Schur complement 或 iSAM2;需要 6-DoF 时把扰动搬到 ,雅可比的链式结构不变。
结语
多传感器融合的方法骨架可以概括为一句话:把每个观测写成状态空间中的残差,把每个残差对扰动求导成雅可比,把雅可比按物理语义分组加权,再把加权后的稀疏正规方程交给 LM 求解。
观测构造决定“问题有没有信息”,雅可比决定“优化方向对不对”,损失决定“粗差会不会毁掉解”,稀疏优化决定“能不能实时”。四者缺一不可,也都不能靠调参替代。把这四步写清楚,方法就可以迁移到不同的平台、不同的传感器组合和不同的任务,而不必绑定某一次具体实验。
说明:本文聚焦观测建模、雅可比推导、损失构造与稀疏优化方法,不涉及具体平台、具体数据或实验结果。公式中的参数均为符号化表示,实际取值需要结合传感器噪声、平台运动学和实时预算确定。

Comments